Quería pasar de una imagen a un objeto 3D coloreado, editable y razonablemente parecido a la referencia. En mi computadora. Sin una GPU dedicada. Y, si era posible, sin esperar media hora cada vez.
El resultado de ese recorrido es Local Multipart 3D: una pipeline que combina planificación con IA, reconstrucción con Hunyuan3D-2mv Turbo en CPU y ensamblado con Python y Blender.
Pero antes hubo varios mapaches que preferiría no volver a ver.
El primer intento: más agentes
La idea inicial era repartir el trabajo entre modelos pequeños. Un agente construía en Blender, otro elegía acciones acotadas y un crítico independiente revisaba los renders. Un controlador determinista conservaba las revisiones, los permisos, los presupuestos y los criterios de aceptación.
Después dividí el personaje en cabeza, cuerpo y cola, con constructores y revisores en paralelo. También probé Three.js y prompts más estrictos.
La infraestructura funcionaba. El personaje seguía estando mal.
| Ensayo | Tiempo registrado | Resultado |
|---|---|---|
| Luna Max + Perplexity | 27m33s | Cancelado, sin personaje aceptado |
| Blender: constructor High + juez Max | 24m38s | El juez aprobó; la calidad falló |
| Blender en paralelo | 32m29s | Partes y conjunto aprobados; rechacé el resultado |
| Three.js en paralelo | 24m50s hasta la última revisión | Inconcluso; la cabeza seguía rechazada |
Los tiempos terminan en eventos diferentes y los ensayos no fueron una comparación controlada. El de Three.js tardó 10m27s en mostrar la primera vista. Tampoco medí un baseline one-shot que permita calcular una aceleración.
Lo que sí pude comprobar fue bastante práctico: estos flujos no me dieron un personaje aceptable más rápido. Las partes ya estaban mal antes de ensamblarlas. Más coordinación y más revisiones no corrigieron caras planas, hocicos extraños ni patas mecánicas.
Y el juez podía decir READY frente a algo que visualmente no cumplía. Un GLB que abre, tiene materiales y pasa controles de geometría sigue pudiendo ser un mal modelo.
Dejé el detalle en el reporte de modelado 3D. No probé con esos ensayos que todos los modelos pequeños sean incapaces de modelar, ni comparé contra modelos mayores. Probé esos flujos con ese personaje, y fallaron.
El segundo intento: reconstruir las siluetas
Otra línea intentó aprovechar varias imágenes del mismo mapache sin usar un segundo modelo de IA para generar la geometría:
PNG con alfa → siluetas → cámaras ortográficas → vóxeles → malla → GLB
Probé más vistas, más resolución, tolerancia a contradicciones, suavizado, texturas, calibración y selección automática de imágenes.
Con formas sintéticas y cámaras conocidas, el método funcionaba. Con las vistas generadas del mapache, la fidelidad seguía siendo insuficiente. Los ángulos pedidos al generador de imágenes no eran cámaras medidas, y las distintas vistas no necesariamente describían el mismo sólido.
Dos números del informe de cierre muestran el límite:
- Con tallado estricto, pasar de 12 a 24 vistas bajó la IoU de silueta de 0,8980 a 0,8737.
- Subir de 128³ a 256³ vóxeles llevó el tiempo de 3,03 a 17,34 segundos, mientras la IoU bajó de 0,9091 a 0,9062.
Son comparaciones internas de ese experimento. IoU mide superposición de contornos; no mide por sí sola anatomía, relieve facial ni utilidad del asset.
El filtro posterior revisó 26 candidatas. Quince pasaron individualmente, pero el conjunto volvió a fallar. Había 38 pruebas de software aprobadas y controles sintéticos positivos; el mapache seguía sin servir para el objetivo.
Cerré esa línea. El código y los diagnósticos quedaron como evidencia de lo que no había funcionado.
Cambiar quién genera la geometría
El siguiente paso fue usar modelos entrenados para imagen a 3D y dejarle al LLM la interpretación, la planificación y la revisión.
Empecé con TripoSR. Después probé Hunyuan3D-2mv Turbo, que admite varias vistas en una reconstrucción conjunta. La prueba local sobre el mapache, en un i7-11800H, dio estos resultados:
| Método | Generación | Pico RSS | IoU media de tres vistas |
|---|---|---|---|
| TripoSR, una vista | 36,41s | 3,61 GiB | 0,7322 |
| Hunyuan, una vista | 169,92s | 6,81 GiB | 0,7292 |
| Hunyuan, tres vistas | 330,74s | 6,80 GiB | 0,7966 |
Cada generación se ejecutó una vez. Los tiempos incluyen arranque, carga e inferencia del generador; excluyen descargas, limpieza, evaluación y renders. Hunyuan multivista mejoró el perfil y la espalda, con una pequeña pérdida en el frente. Todavía era geometría sin textura, con artefactos. El registro reproducible conserva parámetros y límites.
El gato: geometría y color
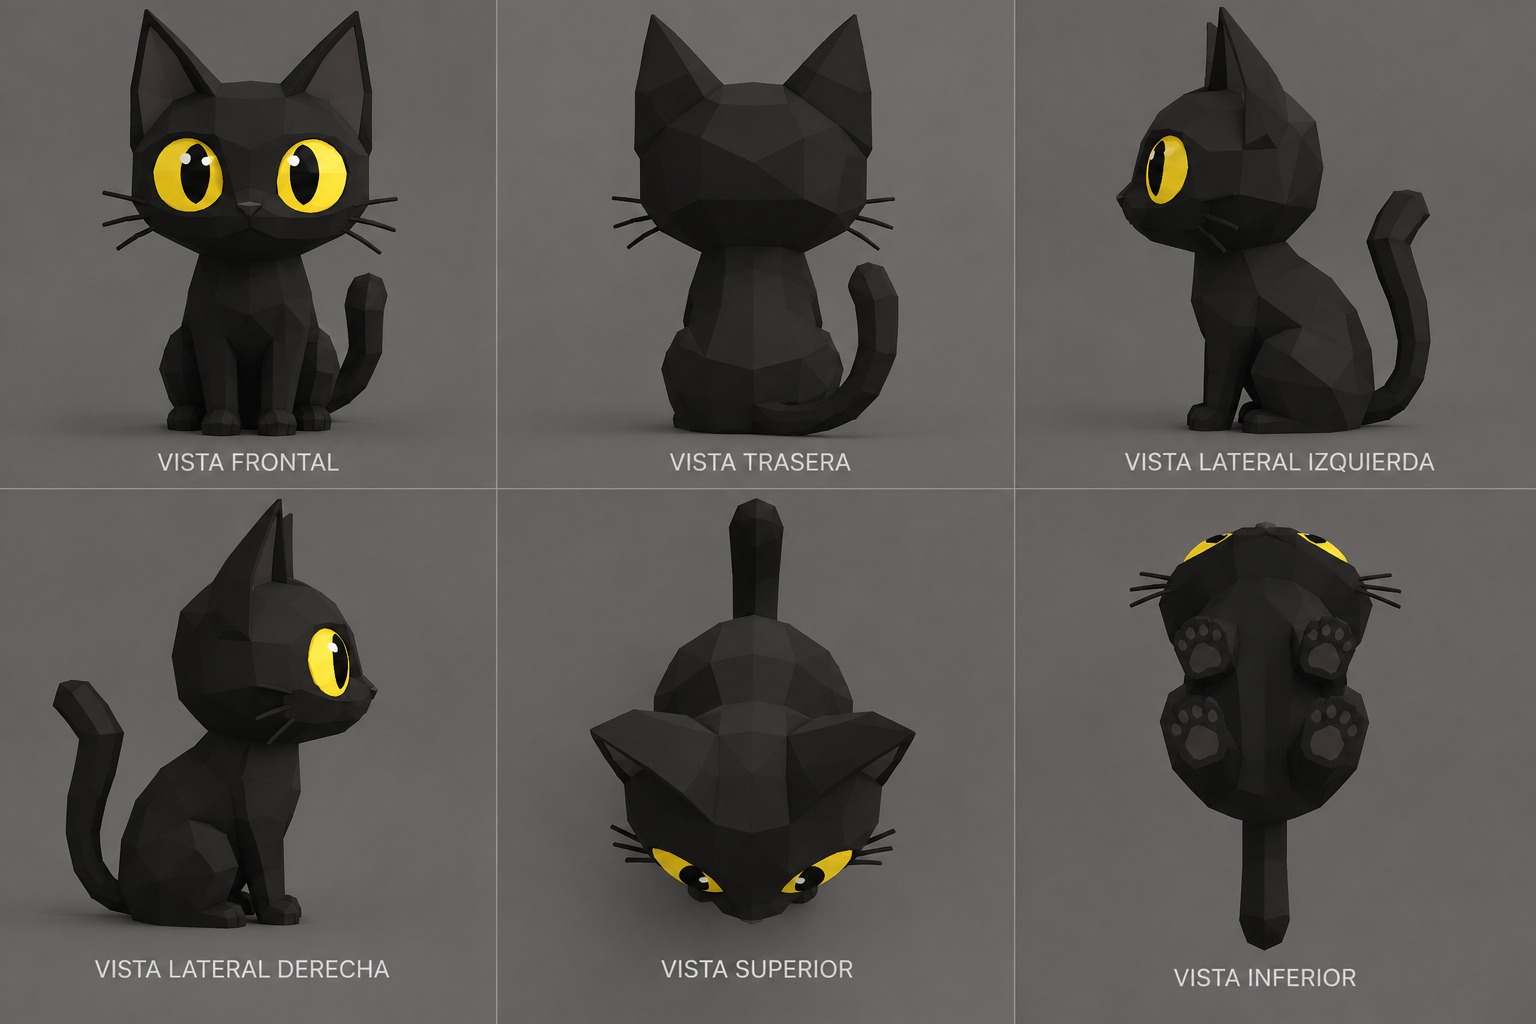
Esta era la lámina de referencia:
Y estos son renders del GLB reconstruido:
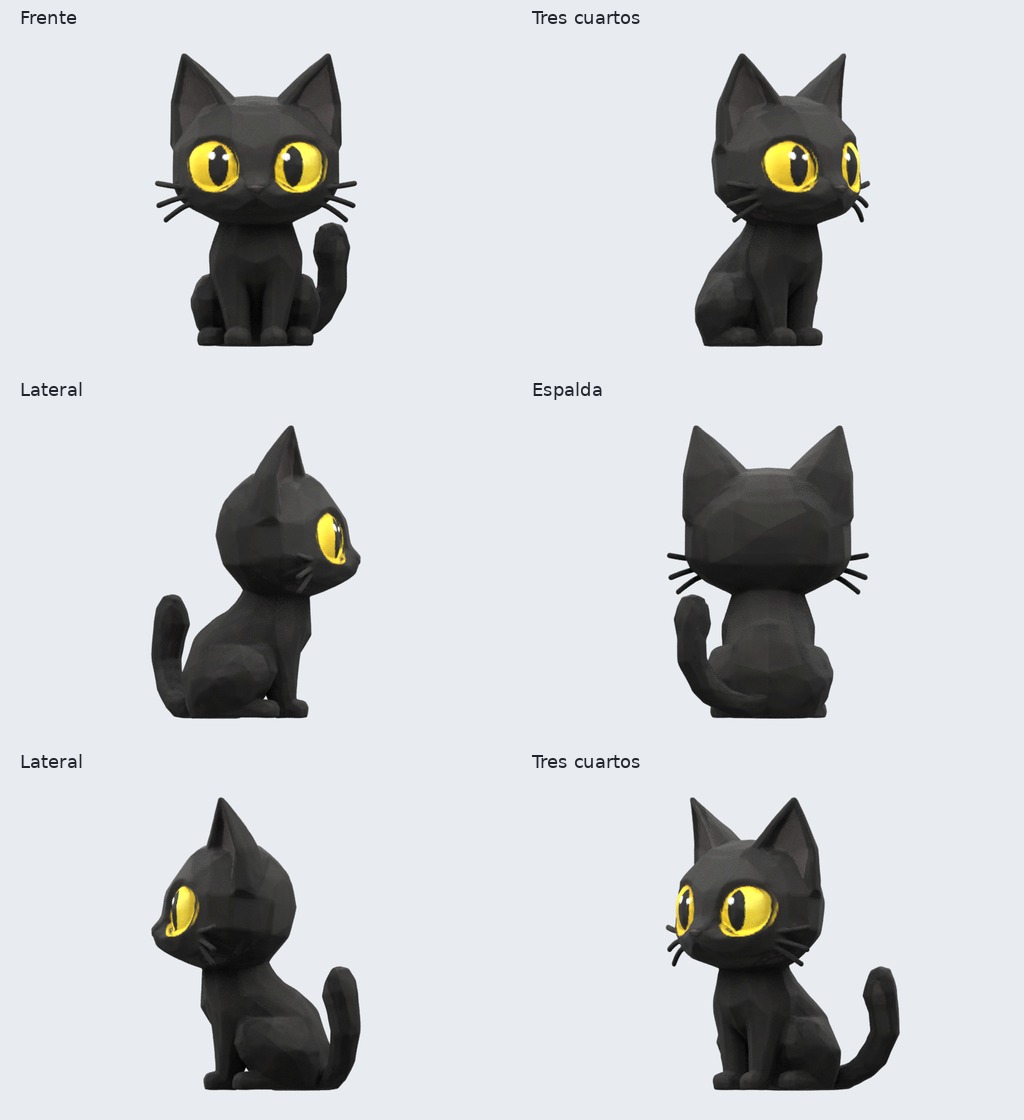
Hunyuan recibió frente, ambos laterales y espalda. La generación tomó 480,20 segundos, unos ocho minutos, con 6,75 GiB de pico RSS. Para el color usé también las vistas superior e inferior.
El negro del cuerpo y el amarillo de los ojos quedaron incorporados como colores por vértice. La proyección verifica visibilidad por profundidad para reducir el color que atraviesa el objeto desde una vista incorrecta. Las zonas sin cobertura reciben un color de respaldo.
Eso permitió entregar un GLB coloreado y renderizarlo en Blender. La proyección también conserva parte de la iluminación de las imágenes; no recupera automáticamente un material físico limpio.
La moto: dónde se nota el límite
La referencia era una sola fotografía:
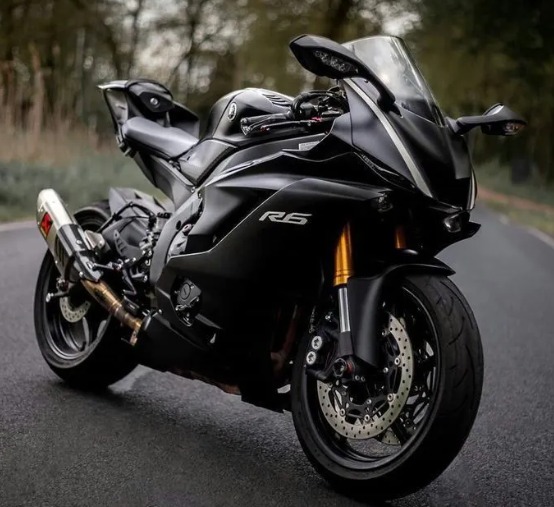
Generé seis vistas con Codex y usé cuatro para Hunyuan. Las superficies ocultas en la foto fueron inferidas. Estos son los renders de la primera reconstrucción:
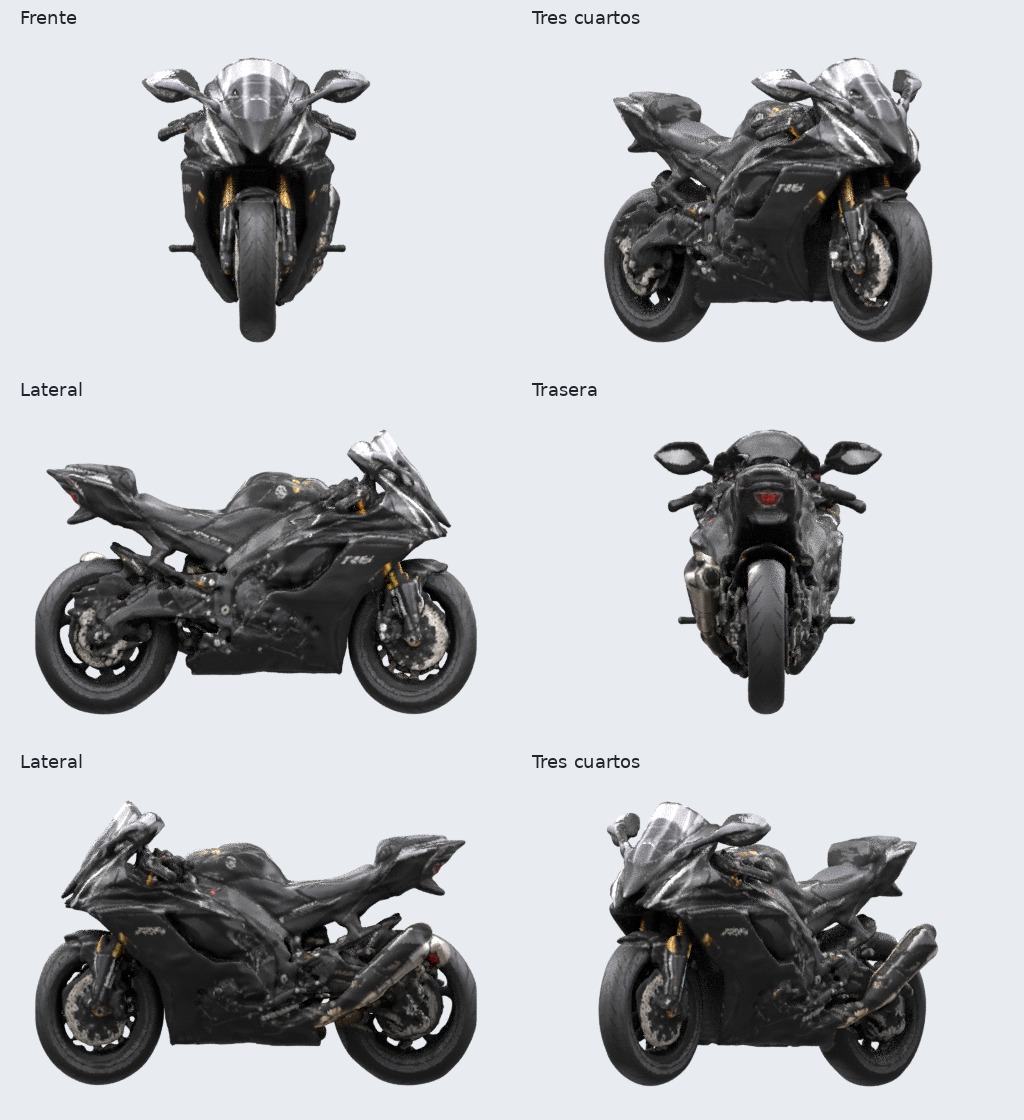
La geometría tomó 8m34s, con 6,75 GiB de pico RSS. Ese tiempo excluye la generación de imágenes y las descargas previas de pesos.
La forma general se reconoce. También se reconocen las ondulaciones en los carenados, los detalles fusionados y las formas blandas. Parte de los reflejos terminó interpretada como relieve.
Entonces reconstruí la moto desde cero con geometría procedural en Blender, organizada en 20 conjuntos editables: ruedas, frenos, horquilla, manillar, paneles, escape.
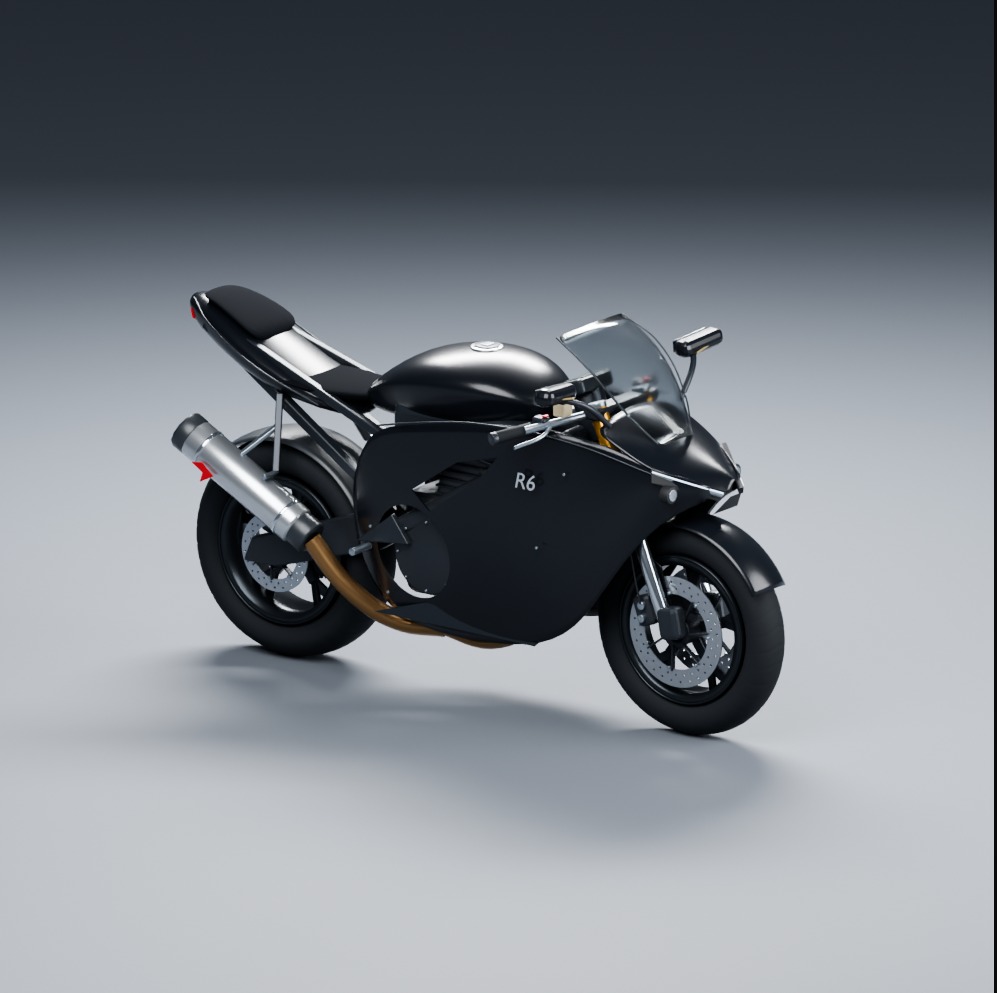
Esta segunda moto es un trabajo específico en Blender. No es la salida automática de Local Multipart 3D, ni un refinamiento de la malla anterior de Hunyuan. Tiene materiales separados y formas mecánicas más controlables; los carenados y detalles ocultos siguen siendo una interpretación de la referencia.
Después hice otro ensayo: reconstruir con TripoSR las mismas 20 piezas, usando renders aislados de la versión procedural como entrada. El workflow completo tomó 17m24s, incluyendo preparación, inspección y reintentos. La versión procedural se veía mejor; el modelo neural volvió a ablandar y deformar piezas.
La descomposición ayudaba a controlar el objeto, pero cada pieza generada agregaba trabajo. No había una razón para pedirle a una red que reinventara un cilindro o una rueda cada vez.
Lo que terminó en el repositorio
Local Multipart 3D combina reconstrucción neural, primitivas y helpers de Blender según lo que necesita el objeto. El planificador decide la división; no hay una regla de “siempre veinte partes”. Una forma esculpida conectada puede quedarse entera. Una pieza repetida puede generarse una vez e instanciarse varias veces.
El flujo actual es:
Imagen o prompt
  → planificación y receta JSON
  → atlas multivista por pieza
  → reconstrucción Hunyuan en CPU + geometría procedural
  → proyección de color
  → ensamblado y renders en Blender
  → observaciones por vista + revisión del conjunto
  → corrección acotada, exportación y comprobaciones
La política por defecto usa Luna high para interpretar, dividir y observar las vistas; Sol 6.1 medium hace la revisión del conjunto y propone una única receta de corrección. Python valida y ejecuta esas decisiones. Las observaciones pueden correr en paralelo, pero las correcciones tienen un responsable único.
Los trabajos guardan etapas y resultados. Si falla algo después de generar una pieza, se puede retomar sin repetir toda la inferencia. La salida incluye .glb, .blend editable, atlas, receta, renders y reportes.
La geometría, el color y Blender corren localmente. La planificación, las imágenes y la revisión usan la sesión de Codex: el workflow completo necesita acceso online. “En CPU” describe la reconstrucción 3D.
Hubo también pruebas remotas de una linterna y una máscara. La máscara tardó 6m31s desde el reintento hasta el resultado, incluida una regeneración. Ese número pertenece al backend remoto Hunyuan 3.1 Rapid. La galería mantiene separados esos ejemplos del backend local.
La prueba completa: una pluma
Para comprobar el repositorio por sí solo, corrí una pluma estilográfica sin editar manualmente la receta ni modelar sus partes a mano. El primer intento falló antes de generar geometría: el prompt de reparación pedía colores en 0–1, mientras el schema esperaba bytes en 0–255. Corregí esa contradicción y repetí el trabajo.
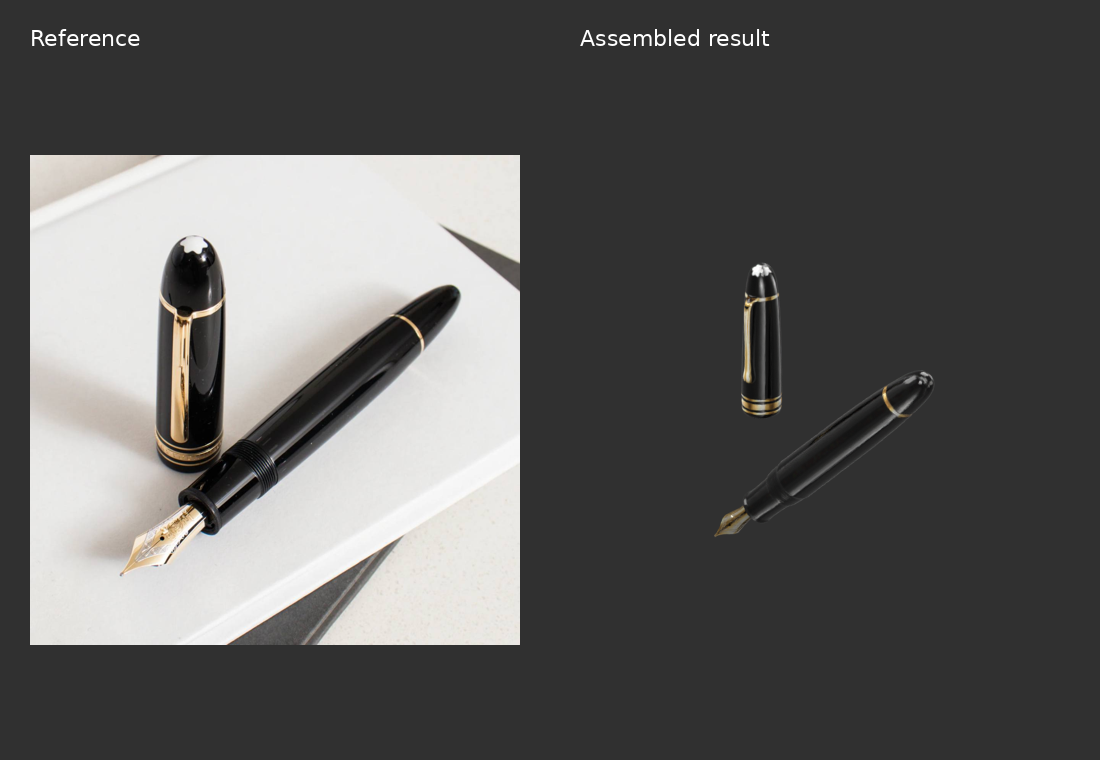
El segundo intento generó cuerpo, plumín y tapa separada, con un único worker de CPU:
- 17m48s hasta el primer export válido.
- 29m55s hasta terminar, incluyendo dos regeneraciones.
Los exports pasaron las comprobaciones locales. El plumín, la rosca, el clip y el emblema siguieron simplificados. El estado visual quedó como unverified_after_correction: pasar controles después de corregir no implica haber obtenido una nueva aprobación visual.
Menos de diez minutos sigue siendo un objetivo para trabajos pequeños. La evidencia de la pluma muestra cuánto tomó un trabajo local completo.
Probarlo
El repositorio contiene los scripts de instalación, el código, una skill de descomposición y la guía completa. Requiere Linux, Python, Blender en el host y Codex autenticado; el setup inicial descarga los pesos.
Con el entorno preparado, un trabajo local se envía así:
.venv-orchestrator/bin/python -m app.multipart.cli submit \
  --root outputs/local-jobs --profile local-cpu \
  --images /ruta/absoluta/referencia.png \
  --instruction "Crear un asset 3D coloreado siguiendo la referencia" \
  --ai-policy luna-sol --cpu-workers 2 --cpu-threads 8 \
  --submission-limit 6 --max-estimated-usd 0 --run
Cada usuario puede elegir el número de workers y los hilos por inferencia. Hay guardas de memoria y presupuesto de hilos; dos procesos comparten CPU y ancho de banda, así que el paralelismo necesita medirse en cada máquina. Para partir de texto se omite --images.
El código y la documentación del proyecto están publicados bajo Apache-2.0, con metadatos REUSE. Los modelos externos y las referencias conservan sus respectivos derechos.
Lo que me queda de este trabajo es una pipeline que puedo correr, inspeccionar y retomar. También un criterio más exigente para leer sus resultados: abrir un archivo, aprobar tests y reconocer un objeto son avances distintos de reproducir bien la referencia.
Informes y fuentes
- Más agentes, sin mejor resultado — PDF en español.
- Informe de cierre de reconstrucción por siluetas — PDF en español.
- Código, guía y galería de Local Multipart 3D, revisados al publicar este post.
Las imágenes del gato y la moto documentan ensayos previos al empaquetado del workflow. La pluma documenta una ejecución de la implementación publicada. Las referencias se muestran para comparación; su inclusión no concede derechos sobre fotografías o diseños ajenos. Las cámaras e iluminación de referencia y resultado difieren.